Loading library
คลังทั้งหมด
แสดง 2 จาก 2 รายการ
Articleฟรี
Kimi K3 + Fable: การผสานโมเดล AI สู่ประสิทธิภาพสูงสุด
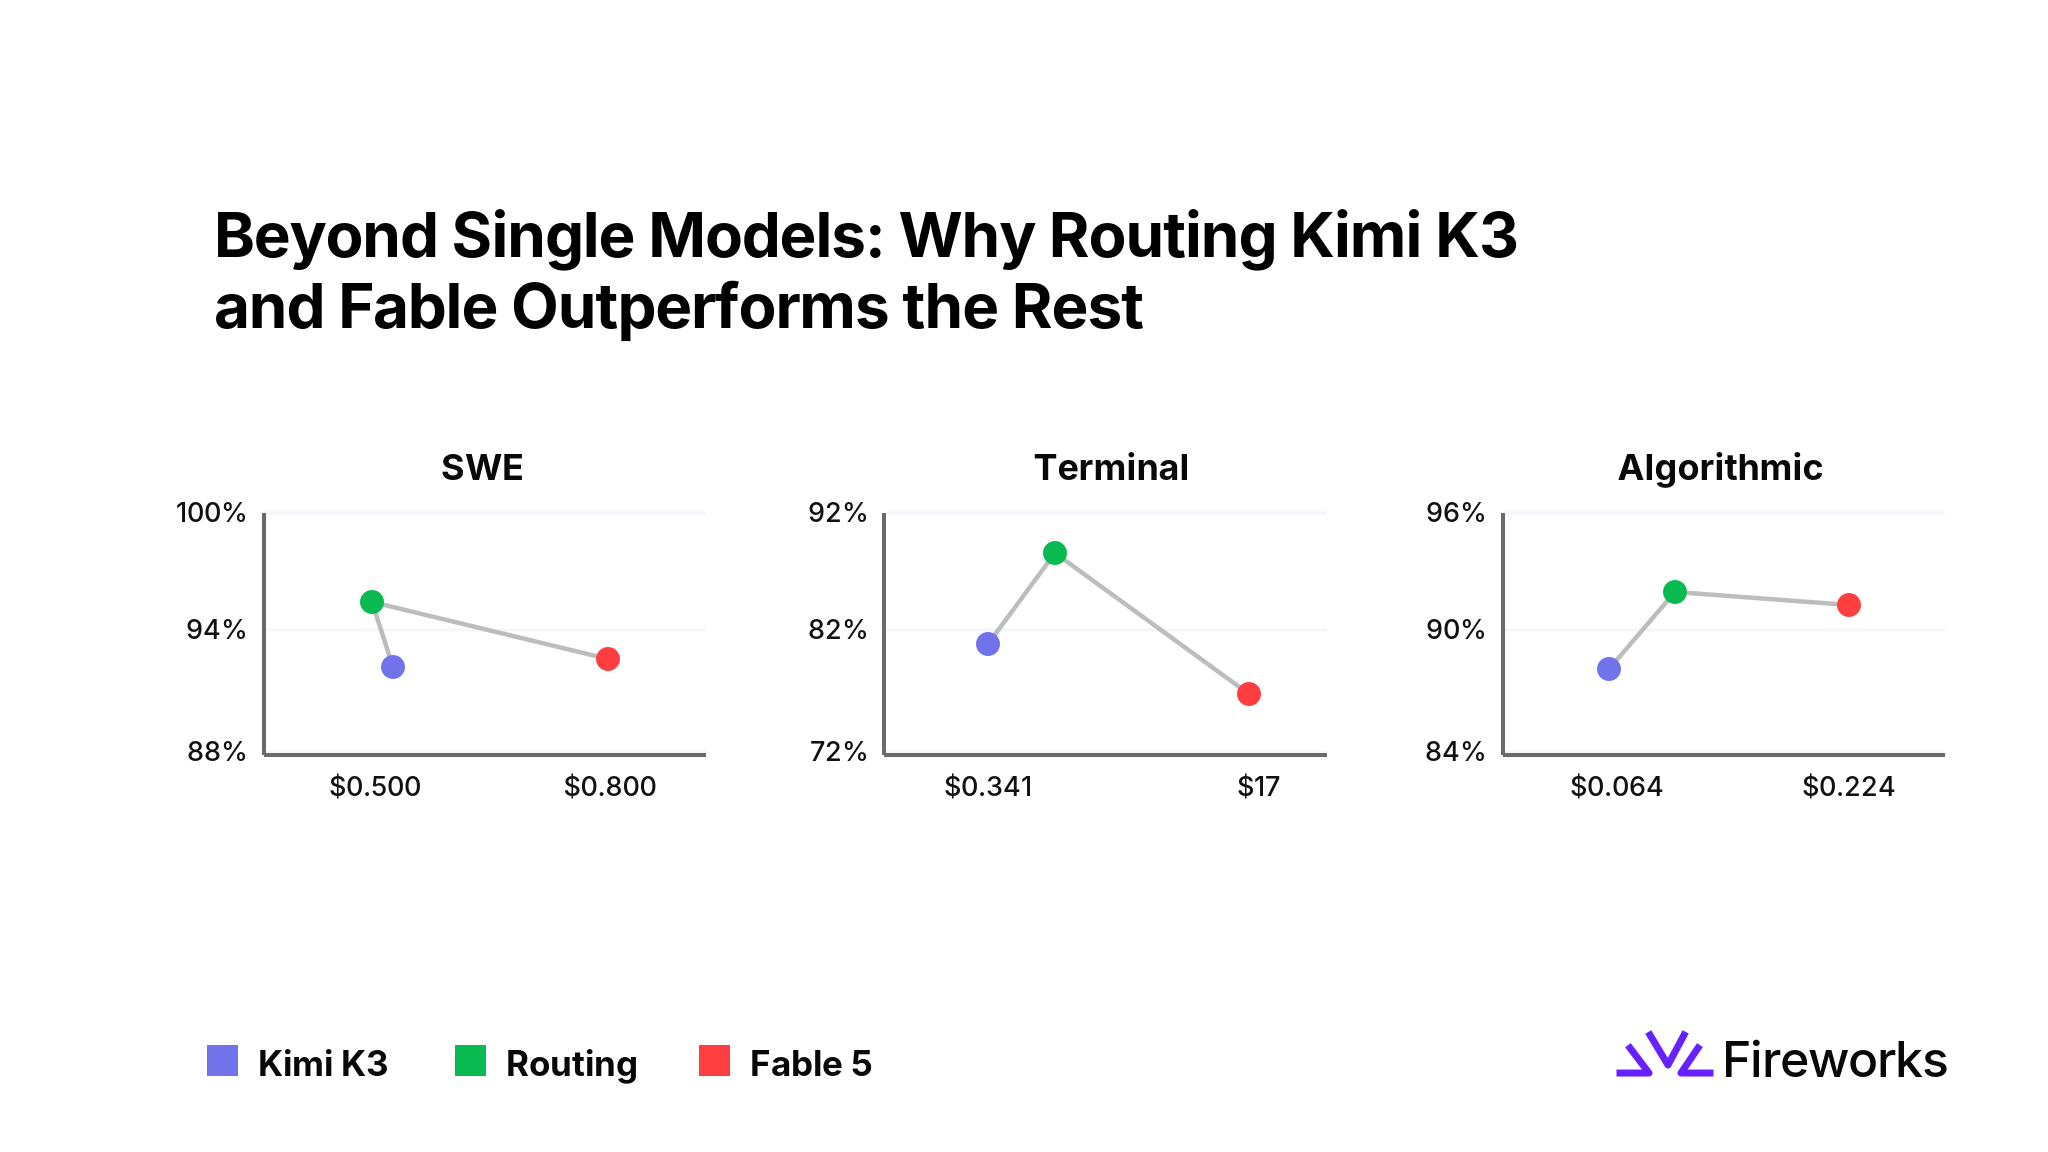
Fireworks.ai เผยผลทดสอบ Kimi K3 (โมเดลเปิด) กับ Fable (โมเดลปิด) ในงาน agentic กว่า 1,000 tasks พบว่าการใช้ routing อัจฉริยะระหว่างสองโมเดลให้ accuracy 93% และประหยัดต้นทุนได้สูงสุด 98% (50 เท่า) เมื่อเทียบกับใช้ Fable เพียงอย่างเดียว
cost-optimization · benchmarking · routing · ai-models
คัดมาจาก Hacker News · อัปเดต 9 ส.ค. 2569
Toolฟรี
Headroom – บีบอัด context ก่อนส่งให้ LLM ลดต้นทุน token ได้ 60–95%
เลเยอร์บีบอัด context สำหรับ AI agent ช่วยลด token ได้ 60–95% (JSON ใน tool call/API response) และ 15–20% (โค้ดไฟล์ .py/.ts/.js จาก TypeScript project benchmark) โดยคงคำตอบเหมือนเดิม แต่แลกมาด้วย latency เพิ่ม รองรับ library, proxy, agent wrapper, MCP server พร้อมบีบอัดแบบ reversible (CCR) เก็บต้นฉบับไว้ดึงกลับได้ ตัวอย่างจริง: ลดจาก 10,144→1,260 token (87.6%) ยังหา error ได้ครบ ไม่เหมาะกับ prompt สั้น <500 token
llm · cost-optimization · compression · local-first
คัดมาจาก GitHub · อัปเดต 6 พ.ย. 2569